【実測】Qwen3-4B をローカルRTX 3090で走らせて測った(IQ4_XS)
当環境で Qwen3-4B(IQ4_XS)を実測。生成速度 123.8 tokens/s、指示遵守 60/100。
当環境で Qwen3-4B(IQ4_XS)を実測。生成速度 123.8 tokens/s、指示遵守 60/100。
当環境で Gemini 3.8 の実測を試み、失敗した。理由: GGUF未提供。
当週の実測ランキングと公表値の比較。
当環境で Qwen3-4B(IQ4_XS)を実測。生成速度 116.89 tokens/s、指示遵守 60/100。
当環境で GPT-6 の実測を試み、失敗した。理由: no gguf。
Tencentが公開したSASは、連続ゲートを用いてKVブロックの選択を最適化。Qwen3対応で推論時のコンテキスト効率を向上させる新手法。
OpenAIモデルと50万時間のEA業務データを活用したAIアシスタントFyxer。53%のドラフト採用率と90%のリテンション率を実現。
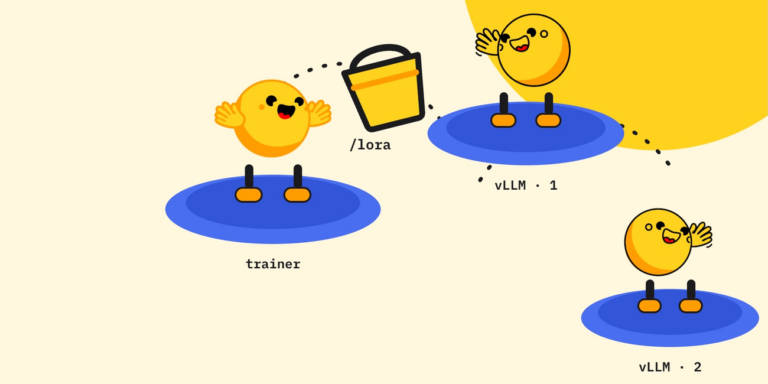
Hugging FaceのAsync GRPO TrainerにLoRA対応が追加。NCCL不要で分散環境を構築し、500ステップの訓練時間を3時間27分から53分へ短縮。
PerplexityがGPT-6 Astraをプロダクション監視に投入。外部サービス模倣による自律テストで、人間チェック頻度を大幅削減。
CognitionがDevinにGPT-6 Astraを統合。AIが自身でテストし、動画やレポートで動作を証明。コードレビューの自動化とリリース速度向上を狙う。