Hugging Face が Async GRPO with LoRA across HF Jobs: a bucket, a proxy, and no NCCL を公開 ── 500ステップの訓練時間を1/4以下へ
RL訓練のボトルネック、それは「重みの同期」だった。数GBのモデルを毎回ネットワークを介してやり取りするのは、分散環境では到底現実的ではない。しかし、今回のアップデートで状況が一変した。Hugging FaceのAsync GRPO TrainerにLoRA対応が加わり、同期するデータが「数MBのアダプタ」に激減。これにより、訓練と推論を別々のマシンで完全に分離しつつ、NCCLのような高帯域通信を必要としない構成が可能になったのだ。
▸何が変わったのか
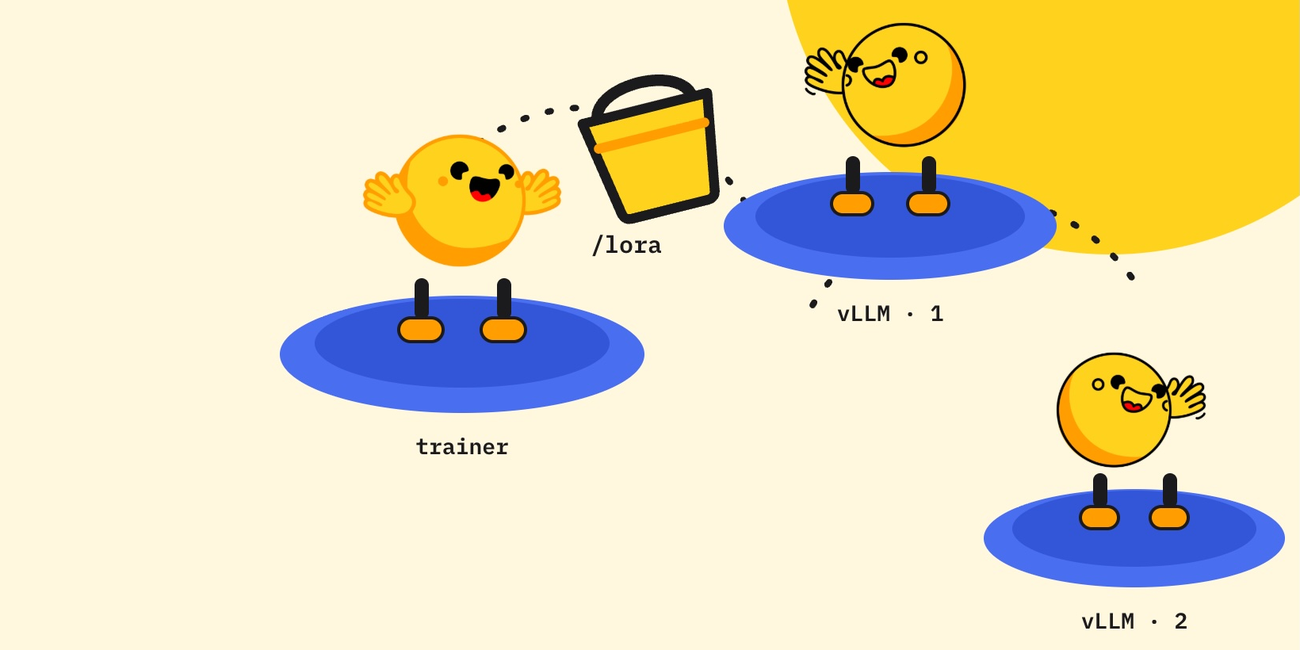
TRL v1.14でAsyncGRPOTrainerのLoRAサポートが実装され、vLLMへの同期対象がフルモデルからLoRAアダプタのみに変更された。これにより、1.5Bモデルなら数MB、フルモデルの約3GBと比較して極小のデータ量で済む。トレーナーとvLLMリプリアは別々のHugging Face Jobsとして実行され、Storage Bucket経由でアダプタを共有する。さらに、プロキシがKVキャッシュの前缀(プレフィックス)を保持するリプリアへルーティングすることで、推論効率も維持。結果として、5回のランで500ステップの訓練時間が3時間27分から53分へと短縮された。
◈前モデル / 競合との比較
従来のフルウェイト同期と比較すると、通信帯域幅の要求が桁違いに低い。Thinking Machinesの「LoRA Without Regret」で示された通り、ランク1のLoRAでもフルファインチューニングと同等のRL性能を発揮できるため、性能犠牲なしにシステム設計の自由度が大幅に向上する。単一クラスタ内でのNCCL利用と比較しても、ジョブ単位で分離可能なため、スケールアップや障害隔離が容易になる。
◈技術背景と意義
なぜLoRAなのかというと、強化学習の利得(アドバンテージ)は1エピソードあたりごく少量の情報しか持たないからだ。つまり、フルファインチューニングほどの巨大な容量は不要で、ランク1のアダプタで十分吸収できる。システム面では、この「軽い」アダプタを共有ストレージに置くだけで、NCCLのような複雑なGPU間通信なしに分散環境を構築できる点が大きい。vLLMは複数のアダプタを同時にロードできるので、古いロールアウトは従来のポリシーで完結し、新しいロールアウトだけ最新のアダプタを使う、というスムーズな遷移も実現できる。
▸こんな人・用途に
「Hugging Face Jobs上で大規模RLを回したいが、単一ノードのメモリやGPU制限に引っかかる」エンジニア。「NCCLの設定やクラスタ管理に時間を取りたくない」研究開発者。「推論サーバーのダウンタイムなく、新しいポリシーを段階的に反映したい」運用担当者。
▸Hacker Newsの反応
提供されたデータ内に当該トピックに関する反応は見つからなかったため、紹介できる情報はゼロの状態。
◆入手方法・リンク
TRL v1.14以降を使用可能。Hugging Face Jobs上で構成可能で、具体的なコードや設定は関連するGitHub PR(#7017)や公式ドキュメントを参照すること。
SOURCE: Hugging Face (2026-09-14)