Hugging Face が Scaling Indic Pretraining: 2.8 Trillion Tokens and an Open Data Generation Pipeline を発表 ── 22言語・1.2億人の母語データに挑む
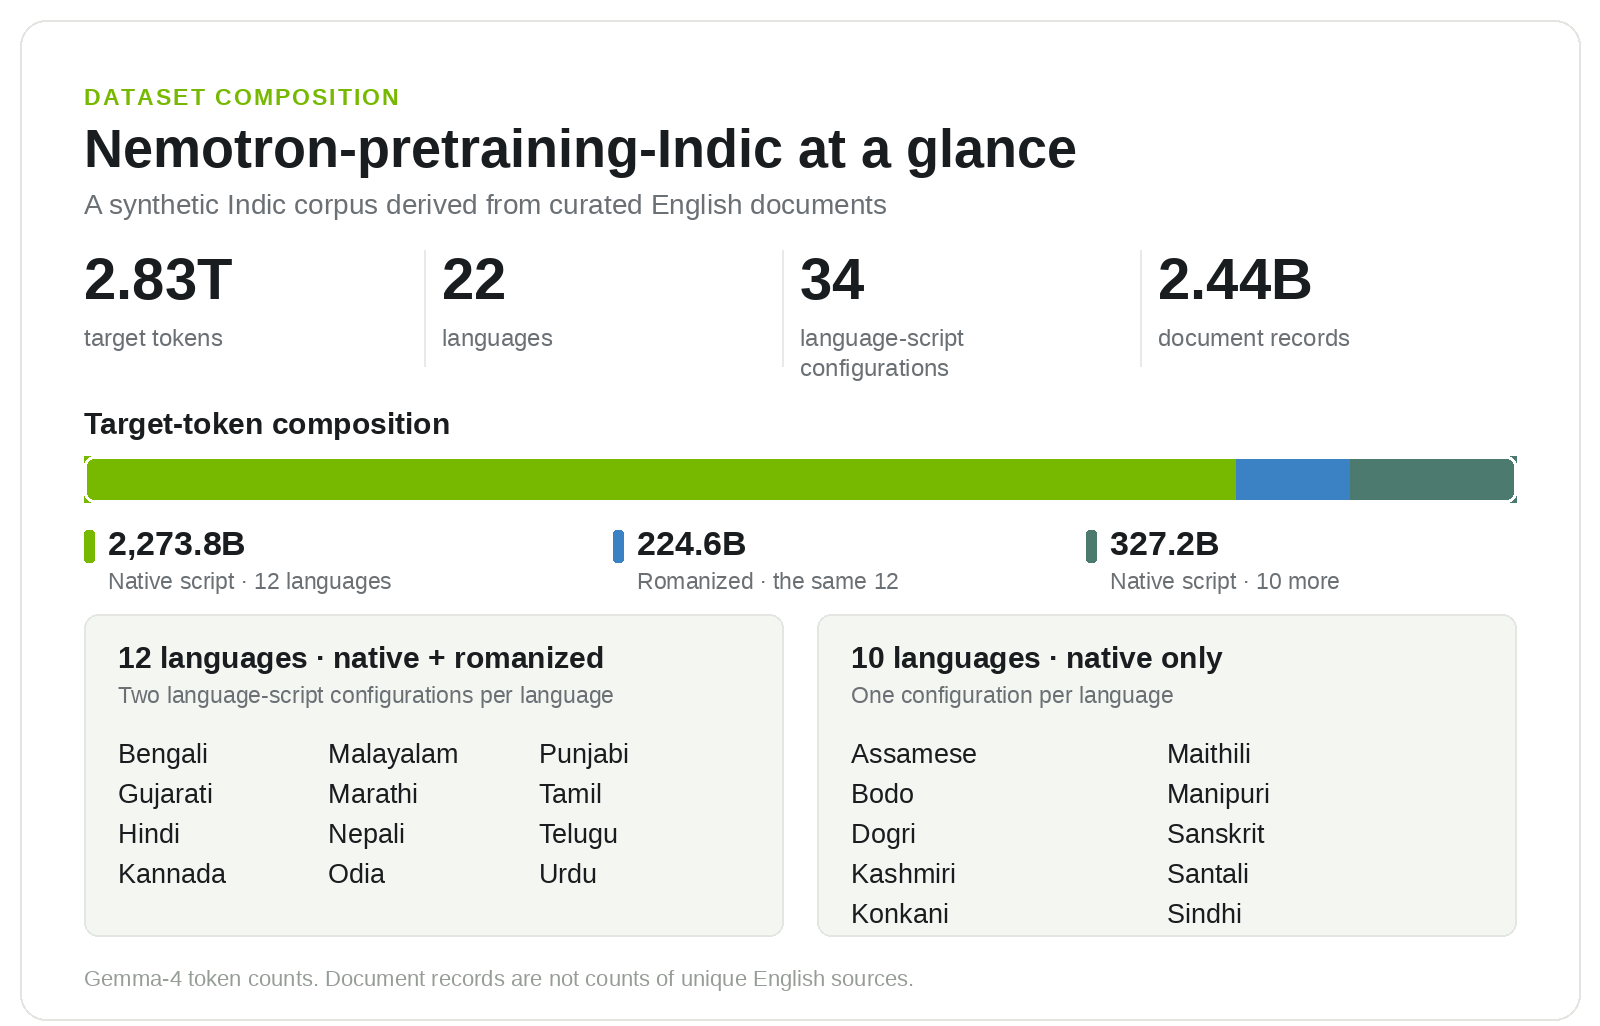
インドの憲法で定められた22の言語すべてを対象に、約2.8兆トークン規模の事前学習データセットが登場した。NVIDIAとIIT Madrasが共同開発した「Nemotron-pretraining-Indic-v1」だが、単なる巨大データ集ではない。生成に用いたGPU加速パイプラインまでオープンソースとして公開される点が、このリリースの本質的な価値だ。
▸何が変わったのか
インド憲法に列挙された22の言語(母語話者がインド国民の97%、約12億人)をカバーする事前学習コーパスが追加された。ネイティブ文字表記に加え、12言語のローマ字表記も含まれ、合計34の言語・表記組み合わせに対応している。数学・コード・Q&Aなど英語でキュレーションされた技術コンテンツを、各言語へ翻訳・生成するプロセスが組み込まれている。各レコードは元のキュレーション済みドキュメントに遡及可能で、出力と入力の照合による品質チェックも実施されている。生成に使われたプロンプト、LLMワークフロー、品質評価・修正プロセスを含む「レシピ」全体が公開される。
◈前モデル / 競合との比較
提供テキストには直接的な競合モデルや前バージョンとのベンチマーク比較数値は記載されていない。ただし、AI4Bharatラボが以前公開した「Sangraha」コーパスからの大幅な拡大と位置づけられており、オープンなインド語系合成学習データとしてコミュニティに提供される規模感が以前とは桁違いである点は言及されている。

◈位置づけと意義
インド言語のAI技術が英語圏に追いつけない最大的原因是「データ不足」とされるが、今回その解決策として膨大な規模の多言語データが提供される。単にテキストを集めるだけでなく、英語の高精度な技術文書を翻訳・変換し、品質を自動評価して修正する「合成データ生成パイプライン」が核になっている。このパイプラインはGPUで高速動作し、開発者が自分たちの素材に合わせて再利用可能だ。結果として、モデルが数学の問題を解いたり、コードの説明を行ったり、質問に答えるといった高度なタスクをインド言語でこなすための土台が整う。
▸向いている用途
インド市場向けにローカライズされたカスタマーサポートチャットボット開発、インド言語での教育用AI(数学・プログラミング指導)構築、現地言語での技術文書検索・要約システム構築
◆試してみるには
「Nemotron-pretraining-Indic-v1」およびデータ生成パイプラインは近日公開予定。提供テキスト内の具体的なGitHubリンクやダウンロードページURLは記載されていないため、Hugging FaceやNVIDIAの公式発表を直接確認する必要がある。
SOURCE: Hugging Face (2026-10-19)