Google DeepMind が Gemini 4 Argon を公開 ── 物理AGIへの足がかり、ERQAで87%のスコア
ロボットの「手先」をAIが直接制御する時代が、少しだけ近づく予感がある。DeepMindが投じたGemini 4 Argonは、単なる言語モデルではなく、物理世界との対話において「身体性」をどう解きほぐすかの答え合わせのようなものだ。特に、シミュレーションでの練習から実機への移行(Real2Sim)をどう自然に行わせるかが、今回の最大の試みになっている。
▸今回の変更点
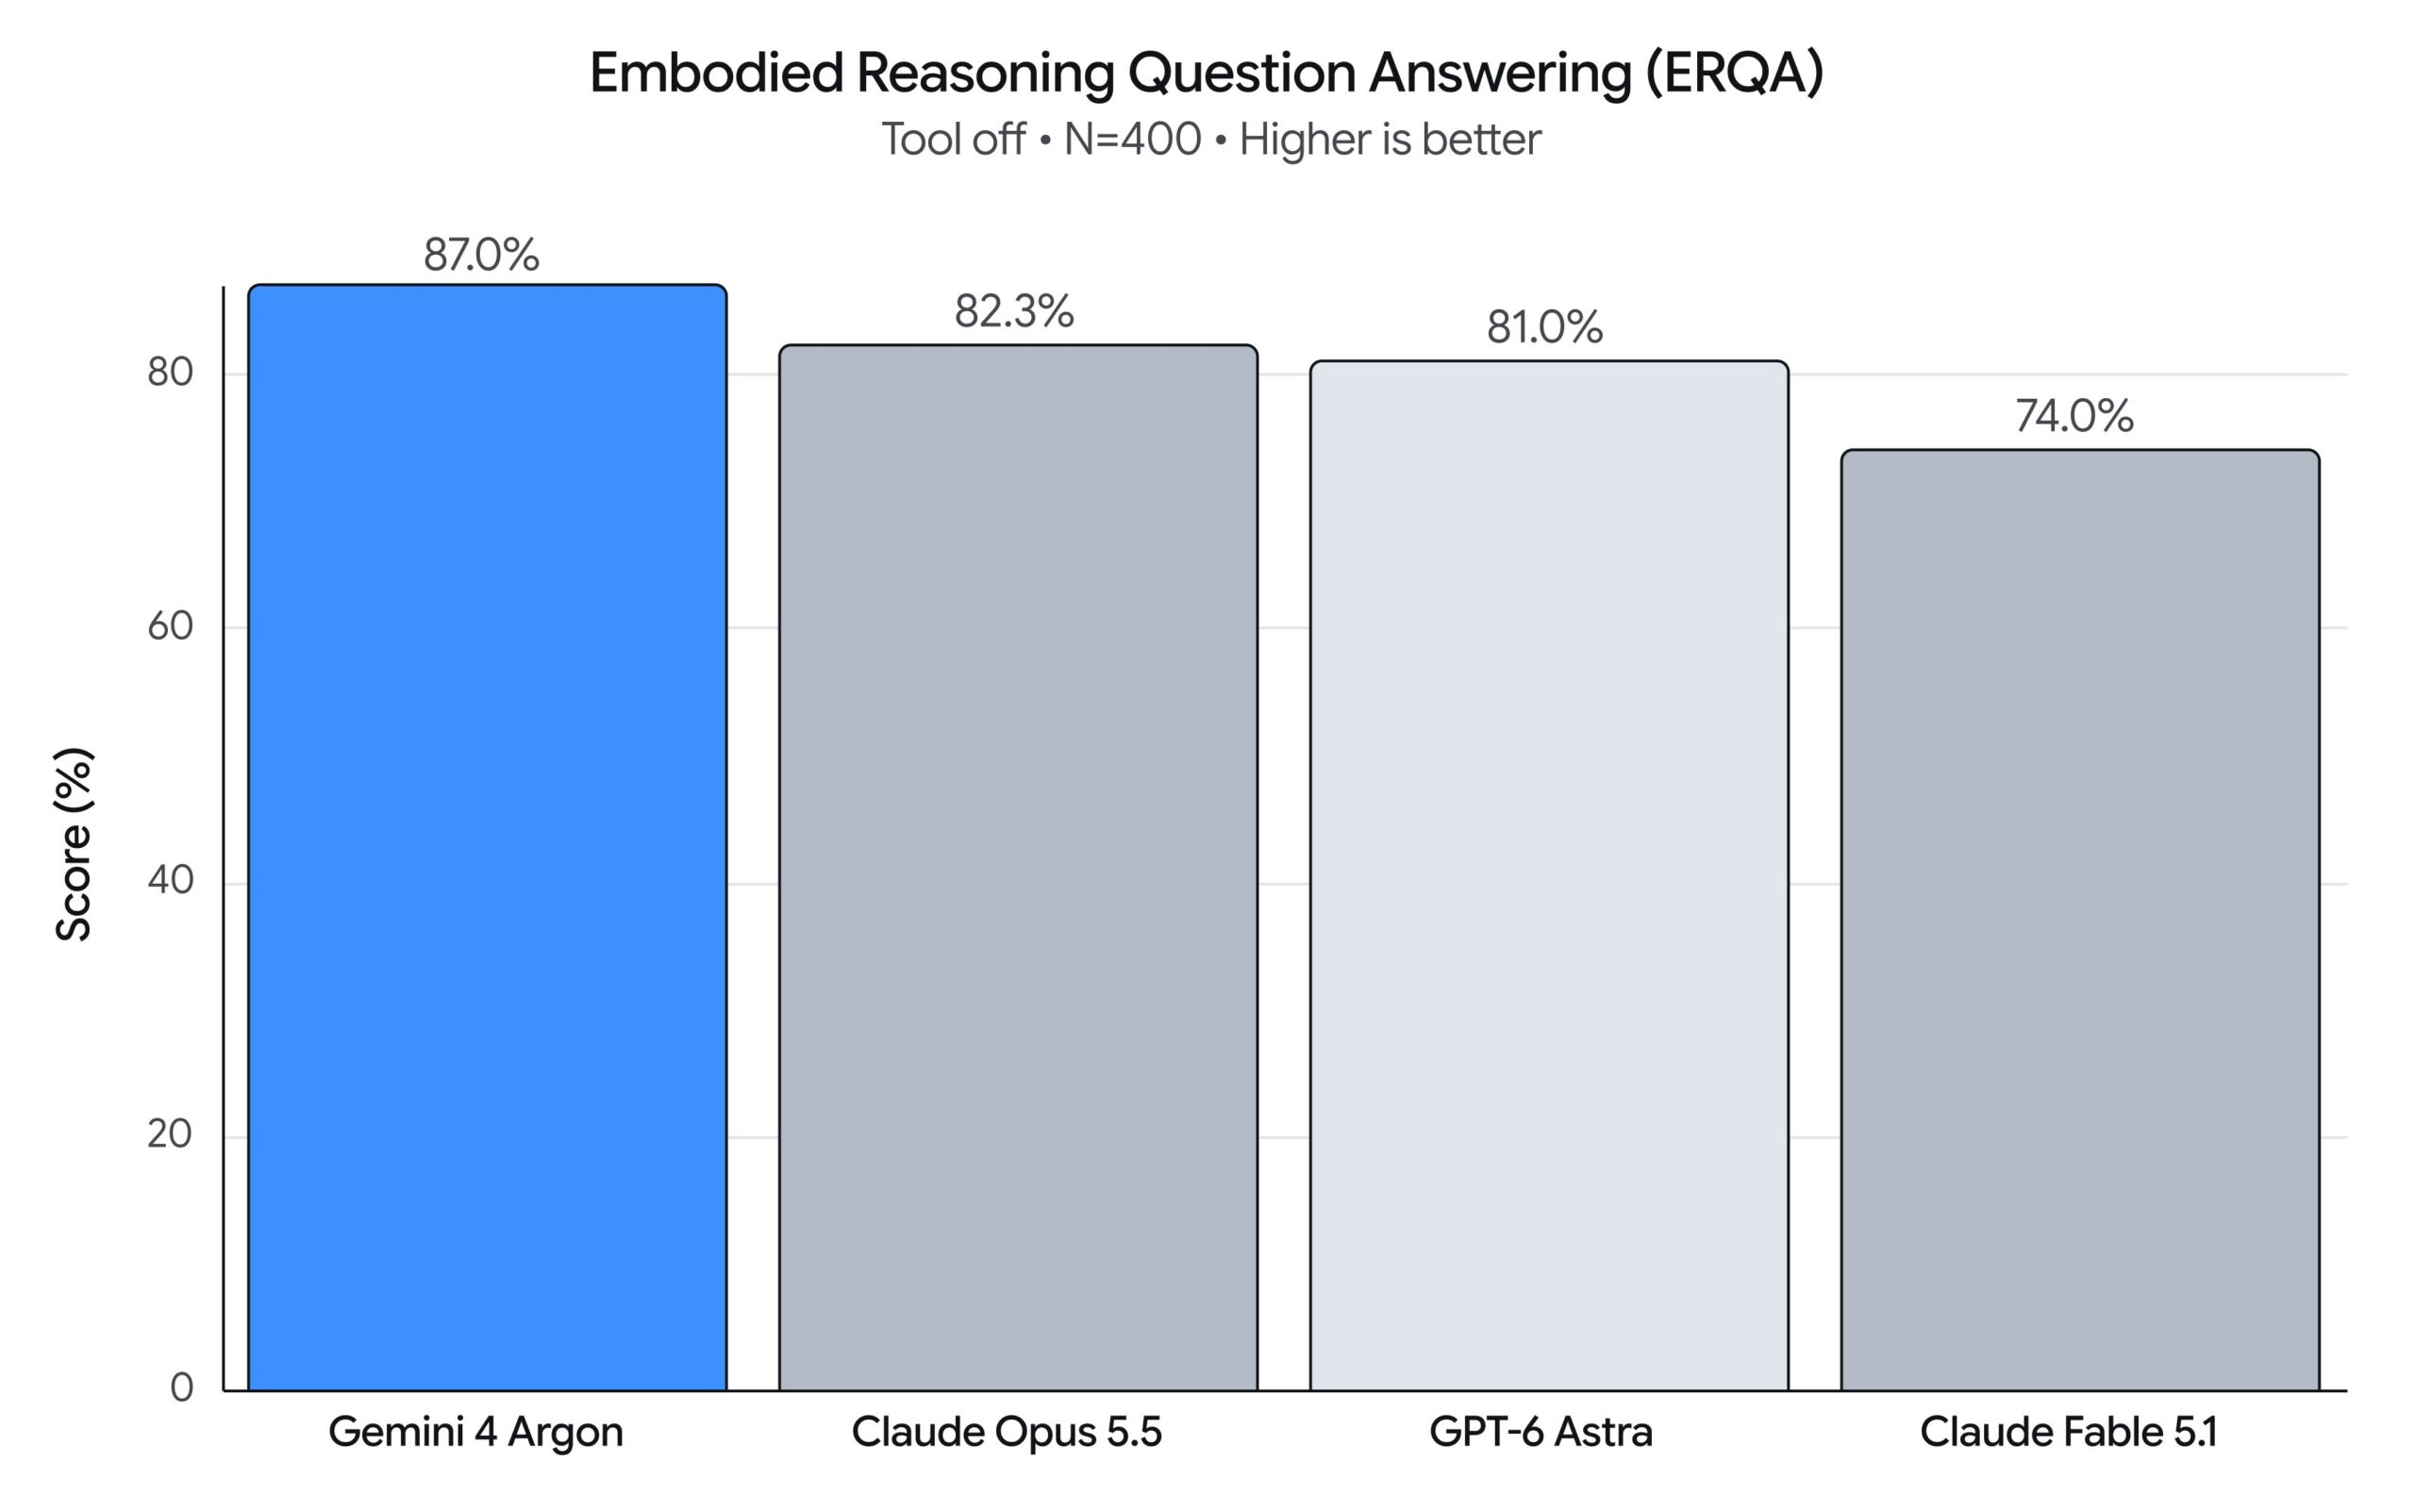
Gemini 4 Argonは、物理的な理解・コード生成・視覚的・意味論的推論において「step change(飛躍的な変化)」を遂げたモデル。Embodied Reasoning (ERQA)ベンチマークでは、3D環境での物理・空間的問題解決能力を純粋な推論で測り、87%というスコアを記録。これは他のフロンティアモデルを上回る数値だ。機能面では、Boston Dynamics Spotの制御、MuJoCoでのデジタルツイン実践、ゼロショットでのロボットアーム操作、およびカメラ映像や手描きスケッチからの物理的に校正されたシミュレーションツインの再構築が可能になった。さらに、巧緻性や進捗推定を含むエージェンティックなマルチモーダル事後ラベリングもサポートしている。
◈前モデル / 競合との比較
ERQAベンチマークにおいて、他のフロンティアモデル(競合の最先端モデル)をすべて上回る87%のスコアを記録。特に、物理空間での推論能力において、従来の汎用LLMや以前のGemini系列と比較して、身体性(Embodiment)を含むタスクへの適応力が大きく向上している点が際立っている。
◈なぜ作られたのか
従来のLLMが「言葉の論理」に強いのに対し、Argonは「物理の論理」を理解する。例えば、ゴミ箱のペダルを踏む際、AIは単に「踏め」という指令を出すのではなく、自分の足がペダルの中心にあるか、手がゴミ箱内に正しく配置されているかを、マルチエージェント(検証エージェント群)を使って視覚的に確認する。この「考える→シミュレーションで試す→実機でやる」というループを、カメラ映像やスケッチから直接シミュレーション環境を生成して実現するのが特徴だ。物理世界での試行錯誤のコストを大幅に減らすための、知的な「下書き」機能を内蔵していると言える。
▸向いている用途
・Boston Dynamics Spotのようなクオドラップド(四足ロボット)を使ったモバイルマニピュレーション(移動しながらの操作)開発。・実機のカメラ映像や人間の身振りを元にした、物理的に正確なシミュレーション環境(Sim)の自動構築。・ロボットアームのゼロショット制御や、シミュレーションでの反復的な自己改善によるハードウェア上の性能向上。
▸Hacker Newsの反応
高スコア投稿には「まだ使えない不満」や「モデルの不安定さへの懸念」が並ぶ一方、StarCraft対戦の話題では「なぜ人間製ボットに勝てるのか」という技術的な謎解きモードに入った。実用性より、今の段階での立ち位置に言及するコメントが多い印象。
「Geminiはいつも精神的に不安定な感じ。これがペーパークリップ問題を引き起こすなら、きっとGeminiだと思うよ」
「初期価格は入力トークン100万ドル2、出力100万ドル10。キャッシュ入力トークンは95%割引。うわー」
「自分の組織(EU)ではまだ利用不可」
「利用できない。さすがGoogle」
「Astraが50%以上勝つのはおかしい。特定ボットとの対戦は許可?強ボット対戦で単位数に落ちるのはなぜ?」
◆公式リンク
クローズドソースであり、GitHub等のオープンソースリポジトリは提供されていない。具体的なAPIアクセス方法や料金体系については、提供された情報には記載がないため不明。
SOURCE: Google DeepMind (2026-10-13)